[논문 리뷰] Evolution Strategy-Based Calibration for Low-Bit Quantization of Speech Models (Rakotoarivony)
한 줄 요약
오디오 모델의 활성값(activation)은 비전·NLP 모델과 달리 극단적으로 넓은 동적 범위를 가져 표준 캘리브레이션으로는 대부분의 값이 같은 정수 레벨로 뭉개진다. 이 논문은 캘리브레이션을 명시적 최적화 문제로 정식화하고, 1) 레이어별 MSE 최소화로 스케일 초기화(로컬) → 2) CMA-ES로 전체 스케일 벡터를 태스크 오차 기준 공동 최적화(글로벌) 하는 2단계 기법 ESC를 제안한다. 완전 INT8에서 성능 무손실, 완전 INT4에서도 5개 음성 태스크 전반에서 기존 캘리브레이션을 일관되게 능가하며, SOTA PTQ와 결합 시 근사 무손실(AST 정확도 상대 1% 하락)을 달성한다. TensorRT 배포 시 평균 2.31배 추론 가속.
1. 배경 및 문제의식
양자화(quantization)는 가중치·활성값의 수치 정밀도를 낮춰 정수 연산 기반 고속 추론과 메모리 절감을 가능하게 하는 핵심 배포 기술이다. 하지만 기존 연구는 비전(CNN, ViT, 확산모델)과 NLP(LLM)에 집중되어 있고, 오디오 도메인은 미개척 상태다.
기존 오디오 양자화 연구의 한계는 다음과 같다.
- 대부분 QAT(양자화 인지 학습) 에 의존 → 학습 데이터의 상당 부분에 접근 필요
- PTQ 연구는 특정 아키텍처 전용이거나 가중치 양자화만 다룸 → 완전 정수 추론에 필수인 활성값 양자화가 방치됨
핵심 관찰 (Figure 1): 정규화된 활성값의 누적분포를 비교하면 ResNet(비전)은 거의 균등, BERT(NLP)는 빠르게 포화하는 반면, Conformer(오디오)는 극도로 압축된 분포를 보인다. 소수의 거대한 이상치가 전체 범위를 지배하기 때문이다. 그 결과:
- 4비트 가중치 양자화(W4/A32): 세 모델 모두 성능 유지
- 4비트 활성값 양자화(W32/A4): Conformer만 성능이 붕괴
즉, 음성 모델 양자화의 병목은 활성값 캘리브레이션이다. 클리핑 범위가 이상치에 끌려가면 양자화 빈(bin)이 심하게 불균형해지고, 대부분의 값이 동일한 정수 레벨로 매핑되어 정보가 소실된다.
2. 제안 방법: ESC (Evolution Strategy-based Calibration)
2.1 양자화 정식화
하드웨어 친화적인 균등(uniform) 양자화를 사용한다.
Q(r) = Int(r/s) − Z
s = (β − α) / (2^b − 1)r: 실수 입력(활성값/가중치),s: 스케일 팩터,Z: 제로 포인트,b: 비트 수[α, β]: 클리핑 범위. 대칭 양자화(α = −β)를 채택해 Z = 0으로 단순화
캘리브레이션이란 이 클리핑 범위(→스케일 팩터)를 정하는 과정이다. 가중치는 학습 후 고정이고 대체로 가우시안 분포라 쉽지만, 활성값은 샘플마다 분포가 크게 변동하므로 n개 샘플로 대표 분포를 추정해야 한다.
2.2 1단계 — 로컬 최적화: MSE 기반 스케일 초기화
활성값 분포 통계만으로 스케일을 정하는 대신, 태스크 오차를 직접 최소화하는 최적화 문제로 재정의한다.
S* = argmin_S E(f_q(x; S), y)f_q: 가중치가 고정된 양자화 모델,S = {s₁, …, s_N}: 레이어별 활성값 스케일 벡터x: 캘리브레이션 샘플,y: 정답,E: 태스크별 오차 지표
초기화는 MSE 캘리브레이션(Choukroun et al., ICCVW'19)으로 수행한다. 각 레이어 i에 대해 독립적으로 FP32 출력과 양자화 출력 간 재구성 오차를 최소화한다.
sᵢ* = argmin_sᵢ ‖l(x) − l_q(x; sᵢ)‖²이렇게 얻은 S가 이후 글로벌 정제의 안정적인 출발점이 된다.
2.3 2단계 — 글로벌 최적화: CMA-ES
레이어별 로컬 최적화만으로는 레이어 간 상호의존성(cross-layer dependency) 을 반영하지 못한다(BRECQ·QAT의 전역 최적화 관점에서 착안). 문제는 목적함수가 양자화 반올림 때문에 비평활(non-smooth)·미분 불가능하다는 것. 그래서 경사 기반 방법 대신 진화 전략(ES), 그중에서도 ill-conditioned·노이즈 목적함수에 강건한 CMA-ES를 채택한다.
CMA-ES 반복 절차:
- 매 반복 t에서 다변량 정규분포
N(m⁽ᵗ⁾, σₜ²C⁽ᵗ⁾)로부터 후보 스케일 벡터 λ개 샘플링 (m: 탐색분포 평균, C: 파라미터 상관을 담는 공분산 행렬, σ: 탐색 반경을 제어하는 전역 스텝 크기) - 각 후보를 태스크 오차 E로 평가하고, 순위 기반으로 (m, C, σ) 갱신
- 목적함수 평가 횟수가 예산 Γ에 도달하면 종료
최종 스케일은 최고 성능 단일 후보가 아니라 최종 탐색분포의 평균을 사용해 노이즈 강건성을 높인다.
2.4 적용 설정
- ESC는 Conv·Linear·LayerNorm 연산자의 활성값 스케일에 적용, 나머지 연산자와 모든 가중치는 Max 캘리브레이션
- 태스크당 학습셋에서 샘플 100개만 사용 (정답 라벨 포함)
- CMA-ES: 초기 스텝 σ = 0.1, 평가 예산 Γ = 100
- 전 과정(캘리브레이션, ES, PTQ, 추론)을 RTX 3090 1장에서 수행
3. 실험 설정: 5개 음성 태스크
| 태스크 | 모델 | 데이터셋 | 평가지표 |
|---|---|---|---|
| 음성인식 (ASR) | Conformer | LibriSpeech | WER↓ / CER↓ |
| 화자인식 | ECAPA-TDNN | VoxCeleb | EER↓ / minDCF↓ |
| 음성향상 | MP-SENet | VoiceBank-DEMAND | PESQ↑ / STOI↑ |
| TTS | FastSpeech 2 | LJSpeech | Mel loss↓ / PostNet loss↓ |
| 오디오 분류 | AST | Speech Commands V2 | Acc↑ / mAP↑ |
모든 모델은 가중치+활성값 완전 양자화(INT8 또는 INT4)로 완전 정수 추론 파이프라인을 구성한다. 비교 기준은 NVIDIA pytorch-quantization 프레임워크의 Max, Percentile(99.99/99.999/99.9999 중 최선 보고), Entropy, MSE 캘리브레이션.
4. 결과
4.1 캘리브레이션 방법 비교 (논문 - Table 1)
INT8 (완전 양자화) — ESC는 사실상 무손실: INT4 (완전 양자화) — 격차가 극적으로 벌어짐:

베이스라인 분석:
- Max: INT8까지는 무난하지만 INT4에서 이상치가 분포를 압축해 붕괴
- Percentile: 이상치 제거로 선전하지만 최적 백분위수가 모델·태스크마다 달라 추가 튜닝 필요
- Entropy: Conformer·ECAPA에는 잘 맞지만 FastSpeech 2·AST에서는 INT8에서조차 크게 망가짐
- MSE: 베이스라인 중 최선. ESC는 MSE를 초기값으로 삼아 그 위에서 추가 개선
흥미로운 결과: MP-SENet은 INT4 ESC에서 PESQ 2.51로 FP32(2.12) 대비 18% 상대 향상. 양자화가 미세한 가중치 기여를 억제하는 정규화 효과로 더 깨끗한 음성을 생성한 것으로 추정된다. AST는 완전 INT4에서도 상대 정확도 하락이 1.75%에 불과하다.
4.2 SOTA PTQ 기법과의 결합 (Table 2, INT4 + ESC)
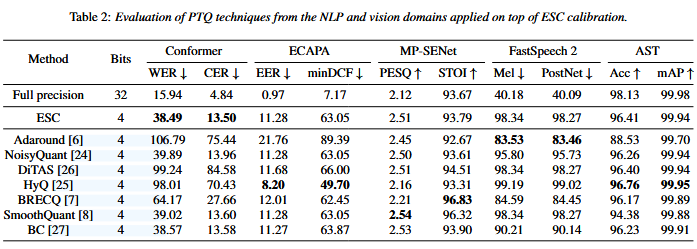
ESC는 활성값 스케일 결정 전략이므로 기존 PTQ와 직교적으로 결합 가능하다. 비전/NLP용 PTQ 7종(AdaRound, NoisyQuant, DiTAS, HyQ, BRECQ, SmoothQuant, BC)을 음성 모델에 적용한 결과:
- 일관된 승자는 없음: 모델별로 결과가 크게 갈려, 오디오 도메인 전용 PTQ의 필요성을 시사
- NoisyQuant, BC, SmoothQuant: 큰 열화 없이 작지만 일관된 개선
- HyQ + ECAPA: EER 11.28 → 8.20 (상대 27% 개선)
- AdaRound + FastSpeech 2: Mel 98.34 → 83.53 (상대 15% 개선) — 단, AdaRound는 Conformer에서는 WER 106.79로 붕괴
- HyQ + AST: 정확도 96.76%로 FP32(98.13%) 근접 → 초록의 "상대 1% 열화" 주장의 근거
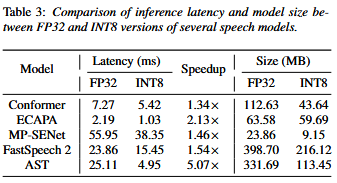
4.3 지연시간·모델 크기 (Table 3, INT8, RTX 3090 + TensorRT)
TorchScript 트레이싱 → TensorRT 배포로 평균 2.31× 가속. RTX 3090 Tensor Core는 INT8은 가중치+활성값 모두 가속하지만 INT4는 가중치만 가속하므로 지연시간 측정은 INT8로 한정했다.
5. 한계
- INT4 ASR은 여전히 실용 수준과 거리: Conformer WER 15.94 → 38.49. "근사 무손실"은 분류(AST)·음성향상(MP-SENet) 쪽 이야기이고, ASR·화자인식은 INT4에서 상당한 열화가 남는다.
- 캘리브레이션에 라벨 필요: 목적함수가 태스크 오차이므로 정답 y가 있는 샘플 100개가 필요 — 무라벨 캘리브레이션인 일반 PTQ 대비 제약
- CMA-ES 비용: 평가 예산 Γ=100은 전체 모델 순전파 평가를 100회 반복한다는 뜻인데, 캘리브레이션 소요 시간 보고가 없다.
- INT4의 실측 지연시간 이득은 미검증 (하드웨어 제약으로 INT8만 측정)
- 코드 미공개, 단일 저자 연구로 재현성 확인이 어려움
- Whisper·wav2vec 2.0 같은 대형 음성 파운데이션 모델에는 미적용 (실험 대상은 모두 100MB급 소형 모델)
6. 시사점
- 온디바이스 음성 모델 배포 관점에서 직접 유용: "음성 모델은 활성값 양자화가 병목"이라는 진단은 Conformer 계열뿐 아니라 LALM 계열 오디오 인코더 양자화에도 적용될 가능성이 높다. 자기 모델의 활성값 누적분포 확인부터 해볼 가치가 있다.
- 적용 장벽이 낮은 방법: 아키텍처 불문, 그래디언트 불필요, 샘플 100개. pytorch-quantization + CMA-ES(pycma) 조합으로 재현 가능한 수준의 단순한 파이프라인이다.
- MSE 캘리브레이션은 공짜 개선점: ESC까지 가지 않더라도 표에서 MSE가 Max/Percentile/Entropy를 일관되게 이긴다. TensorRT 배포 시 캘리브레이터 기본값을 MSE로 바꾸는 것만으로 이득.
- PTQ 조합은 모델별 검증 필수: 같은 기법이 모델에 따라 +27% 개선과 붕괴를 오간다. HyQ·SmoothQuant·BC를 후보군으로 소규모 스윕을 권장.
7. 주요 기술 용어 정리
| 용어 | 설명 |
|---|---|
| Quantization (양자화) | FP32 실수 가중치/활성값을 INT8·INT4 같은 저비트 정수로 매핑해 메모리·연산량을 줄이는 모델 압축 기법 |
| PTQ (Post-Training Quantization) | 재학습 없이 학습 완료된 모델을 소량의 캘리브레이션 데이터만으로 양자화하는 방식 |
| QAT (Quantization-Aware Training) | 학습 중 양자화 연산을 시뮬레이션하며 파인튜닝하는 방식. 정확도는 높지만 학습 데이터·연산 자원 필요 |
| Calibration (캘리브레이션) | 양자화 시 클리핑 범위 [α, β]와 스케일 팩터 s를 결정하는 과정. 이 논문의 핵심 주제 |
| Clipping Range (클리핑 범위) | 실수 입력을 잘라내는 구간. 넓으면 이상치는 살리지만 해상도가 낮아지고, 좁으면 그 반대 |
| Scale Factor (스케일 팩터) | 실수↔정수 매핑 비율. s = (β−α)/(2^b−1) |
| Symmetric / Uniform Quantization | 클리핑 범위가 0 중심 대칭(α=−β, 제로포인트 0)이고 양자화 레벨이 등간격인 방식. 하드웨어 구현이 가장 쉬움 |
| Max / Percentile / Entropy / MSE Calibration | 각각 관측 최대값, 상위 백분위수, KL발산 최소화, FP32-양자화 출력 간 MSE 최소화로 클리핑 범위를 정하는 표준 캘리브레이션 4종 |
| Dynamic Range (동적 범위) | 활성값이 취하는 값의 범위. 오디오 모델은 이 범위가 극단적으로 넓다는 것이 본 논문의 출발점 |
| Evolution Strategy (ES, 진화 전략) | 실수 파라미터의 변이와 선택으로 최적해를 찾는 개체군 기반 무경사(gradient-free) 최적화. 비평활·미분불가 목적함수에 적합 |
| CMA-ES | 다변량 정규분포의 평균·공분산·스텝크기를 후보 순위 기반으로 적응시키는 대표적 ES. ill-conditioned·노이즈 문제에 강건 |
| Cross-layer Dependency | 한 레이어의 양자화 오차가 후속 레이어로 전파·증폭되는 현상. 로컬 최적화의 한계이자 글로벌 최적화의 근거 |
| AdaRound | 가중치 반올림 방향(올림/내림)을 레이어 출력 재구성 기준으로 학습하는 PTQ 기법 |
| BRECQ | 블록 단위 재구성으로 양자화 오차를 최소화하는 PTQ. 레이어 단위와 모델 단위의 중간 granularity |
| SmoothQuant | 활성값의 이상치 스케일을 가중치 쪽으로 이전(smoothing)해 활성값 양자화를 쉽게 만드는 LLM용 PTQ |
| NoisyQuant | 양자화 전 활성값에 고정 노이즈 바이어스를 더해 양자화 오차 분포를 개선하는 ViT용 기법 |
| HyQ | CNN-Transformer 하이브리드 네트워크용 하드웨어 친화적 PTQ |
| DiTAS | 확산 트랜스포머용 활성값 스무딩 PTQ |
| BC (Bias Compensation) | 양자화 출력 오차를 바이어스 보정으로 상쇄하는 기법 |
| Conformer | 컨볼루션+셀프어텐션을 결합한 ASR 표준 인코더 아키텍처 |
| ECAPA-TDNN | 채널 어텐션 기반 TDNN 화자인식(화자 임베딩) 모델 |
| MP-SENet | 크기(magnitude)·위상(phase) 스펙트럼을 병렬 복원하는 음성향상 모델 |
| FastSpeech 2 | 비자기회귀 TTS 음향모델. 멜스펙트로그램을 병렬 생성 |
| AST (Audio Spectrogram Transformer) | 스펙트로그램을 패치로 잘라 ViT처럼 처리하는 오디오 분류 모델 |
| WER / CER | 단어/글자 오류율 (ASR 지표, 낮을수록 좋음) |
| EER / minDCF | 화자검증 지표. EER은 오수락률=오거부율 지점의 오류율, minDCF는 비용가중 최소 검출비용 |
| PESQ / STOI | 음성 품질(1 |
| mAP | 분류 신뢰도 순위 기반 평균 정밀도 |
| TensorRT / TorchScript | NVIDIA 추론 최적화 엔진 / PyTorch 모델 직렬화(트레이싱) 포맷. 본 논문의 INT8 배포 스택 |
| Tensor Core | NVIDIA GPU의 행렬연산 전용 유닛. INT8은 가중치+활성값 모두 가속하지만 INT4는 가중치만 가속 |